扩散模型入门——从MLE到EM
最大似然估计
扩散模型的核心功能是学习图像,然后从生成新的图像,就像一名技术高明的雕刻师,看过很多雕塑以后,就可以从一块大理石中雕刻出精美的石雕。
从概率的角度来讲,把每一张图片都理解为一个数据点,我们的任务是要找出这一批数据的分布情况,这样,我们就能生成最像这一批数据的一个数据
概率论的方法通常是使用最大似然估计(Maximum Likelihood Estimation, MLE)来解决这个问题
怎么做的?举个例子:
假设观测到 5 个数据:D={2, 3, 5, 7, 8},已知他们符合的是高斯分布,我们要找的就是能让他们同时发生的概率最大的参数 θ(在这里就是μ和σ2) ,联合概率(似然函数)可以写成为:
展开带入:
取 log可以把连乘变为求和,因为我们这里是找让这个式子值最大的θ ,所以套一个log无伤大雅
因为 xi 已知,所以在这里未知数就是我们要求的参数(μ和σ2),直接对两个求导
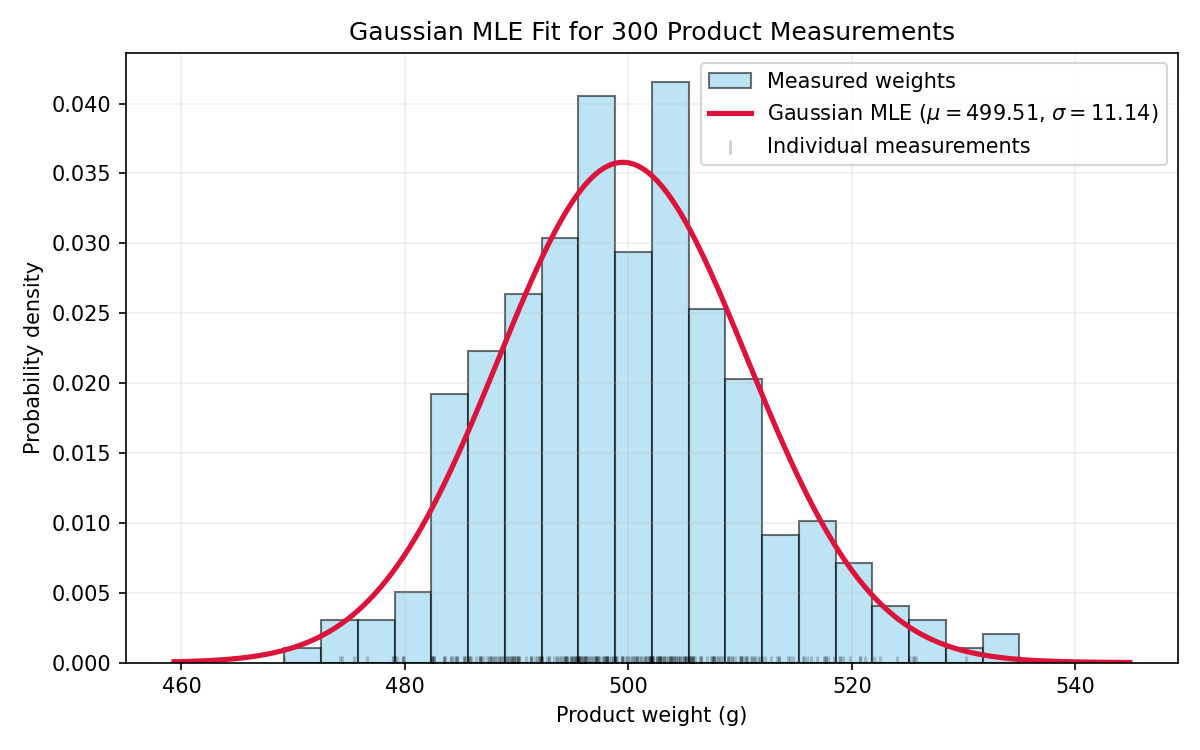
用程序验证一下
from pathlib import Path

import matplotlib.pyplot as plt
import numpy as np


def generate_sample_data(
    sample_size: int = 300, seed: int = 42
) -> np.ndarray:
    """模拟产品重量测量值,单位为克。"""
    rng = np.random.default_rng(seed)

    # 假设产品的目标重量约为 500 g,生产波动的标准差约为 12 g。
    measurements = rng.normal(loc=500, scale=12, size=sample_size)

    # 模拟测量仪器只能精确到 0.1 g。
    return np.round(measurements, 1)


def gaussian_mle(data: np.ndarray) -> tuple[float, float]:
    """返回高斯分布参数的最大似然估计:均值 mu 和标准差 sigma。"""
    mu = np.mean(data)

    # MLE 方差的分母是 n(ddof=0),不是无偏估计使用的 n - 1。
    variance = np.mean((data - mu) ** 2)
    sigma = np.sqrt(variance)
    return float(mu), float(sigma)


def plot_fit(data: np.ndarray, mu: float, sigma: float) -> Path:
    """绘制样本直方图和拟合后的高斯概率密度曲线。"""
    margin = 0.15 * (data.max() - data.min())
    x = np.linspace(data.min() - margin, data.max() + margin, 500)
    pdf = np.exp(-0.5 * ((x - mu) / sigma) ** 2) / (
        sigma * np.sqrt(2 * np.pi)
    )

    plt.figure(figsize=(8, 5))
    plt.hist(
        data,
        bins=20,
        density=True,
        alpha=0.55,
        color="skyblue",
        edgecolor="black",
        label="Measured weights",
    )
    plt.plot(
        x,
        pdf,
        color="crimson",
        linewidth=2.5,
        label=rf"Gaussian MLE ($\mu={mu:.2f}$, $\sigma={sigma:.2f}$)",
    )
    plt.scatter(
        data,
        np.zeros_like(data),
        marker="|",
        s=45,
        color="black",
        alpha=0.18,
        label="Individual measurements",
    )
    plt.xlabel("Product weight (g)")
    plt.ylabel("Probability density")
    plt.title(f"Gaussian MLE Fit for {len(data)} Product Measurements")
    plt.legend()
    plt.grid(alpha=0.2)
    plt.tight_layout()

    output_path = Path(__file__).with_name("gaussian_mle_fit.png")
    plt.savefig(output_path, dpi=150)
    plt.show()
    return output_path


if __name__ == "__main__":
    samples = generate_sample_data(sample_size=300, seed=42)
    estimated_mu, estimated_sigma = gaussian_mle(samples)

    print(f"Sample count: {len(samples)}")
    print(f"MLE mean (mu): {estimated_mu:.4f}")
    print(f"MLE variance (sigma^2): {estimated_sigma**2:.4f}")
    print(f"MLE standard deviation (sigma): {estimated_sigma:.4f}")

    saved_path = plot_fit(samples, estimated_mu, estimated_sigma)
    print(f"Plot saved to: {saved_path}")
隐变量的引入
对于单一分布,MLE 通常可以直接求解。然而,许多实际数据的生成机制并非来自单一分布,而是由多个同族但参数不同的分布共同生成。
例子:身高数据与性别隐变量
1. 单一分布的情形
假设你只调查一群男性的身高,记为
可以合理假设它们来自同一个正态分布:
这时用 MLE 直接估计 μ 和 就行了,没有任何难度。
2. 实际数据的情形
但现实中,你拿到的数据可能是一群男性和女性混在一起的身高,而且你不知道每个人的性别。
这时数据看起来可能是这样的:
一部分人偏高,集中在 175 cm 左右;
另一部分人偏矮,集中在 162 cm 左右;
整体直方图可能呈现双峰。
如果你硬用一个正态分布去拟合,会得到一个大方差的正态分布,效果很差:
这个模型无法刻画“两个群体”的结构,我们假设这个数据属于A群体的概率为,属于B群体的概率为
推导
这是因为实际上对于一个数据的概率由两个变量决定,但是从数据中实际上没有办法看到这个数据属于哪个群体,数据似然可以写成:
如果把这个式子套进去,那对数似然的式子就写成了
很显然,这个无法解析解,因为有log-sum 形式,但是这个式子是能做一些推导的:
进一步的:
最后就是被分解为两部分,一个式子+一个散度,KL散度用来描述两个分布的差异性,知乎上有一篇很好的文章,感谢这位作者:深入理解 KL 散度(Kullback-Leibler Divergence):从直觉、数学到前沿应用的全方位解析 - 知乎
因为,所以,,定义这个式子为ELBO(证据下界),当且仅当的时候可以,不等式取等号,而整个式子与z 无关,因此,整个式子的值没有变化,但是在这时候ELBO触碰到了因此,此时调整θ 使得ELBO增加,那么也会随之抬高。
步骤
所以我们可以分两步处理这个最大化问题:
E步:令 ,根据贝叶斯定理:
也就是说你需要知道隐变量的分布,隐变量情况下的概率先验,然后设定初始值迭代。
M步:确定了
z的分布以后就需要最大化前半部分
对这个式子做一些变形
也就是说后半部分是关于q的函数,我们要求的是使得ELBO最大的θ ,后半部分因为没有θ,可以省掉,所以求最大化ELBO等价于,求前半部分式子的最大化,把前半部分定义为Q函数,即求Q函数的最大化。
仔细看看Q 函数:
这个式子其实是z的后验分布的期望(带了log),注意,此时的q(z) 已经在E 步固定为了当前的后验分布了。
回看一下,整个EM算法的实质,是当我们引入了一个隐变量,导致最大似然的解析形式不好求积分,因此,我们通过推导,找到了最大似然函数的证据下界,然后我们发现,当我们引入的隐分布变成隐变量的后验分布以后,证据下界此时“贴紧了”最大似然函数,这时候固定后验分布q(z) 然后求θ 使得ELBO最大化,进而推动似然函数增大,然后重复E、M步。